Contexto
Un despacho que prepara expedientes con cientos de documentos por asunto: contratos, escrituras, escritos, resoluciones, correos, hojas de cálculo y muchos escaneados. El abogado necesita preguntar al expediente y obtener respuestas con fuente, no un chatbot que contesta de memoria. Construimos un sistema legal completo: backoffice web, app móvil y toda la capa de IA, con legislación y jurisprudencia integradas.
Reto
- Precisión y trazabilidad: cada afirmación tiene que llevar a su documento y página, a su artículo o a su sentencia. Una cita inventada es inaceptable.
- Documentos difíciles: escaneados, tablas, anexos y estructura legal (cláusulas, fundamentos, artículos).
- Lenguaje jurídico: números de artículo, de procedimiento, importes y nombres de parte que la búsqueda semántica sola no encuentra.
- Vigencia normativa: citar el texto consolidado vigente, no la publicación original.
- Confidencialidad: varios despachos en la misma plataforma, sin que un dato cruce de uno a otro.
- Movilidad: consultar el expediente y las fuentes desde el móvil.
Solución
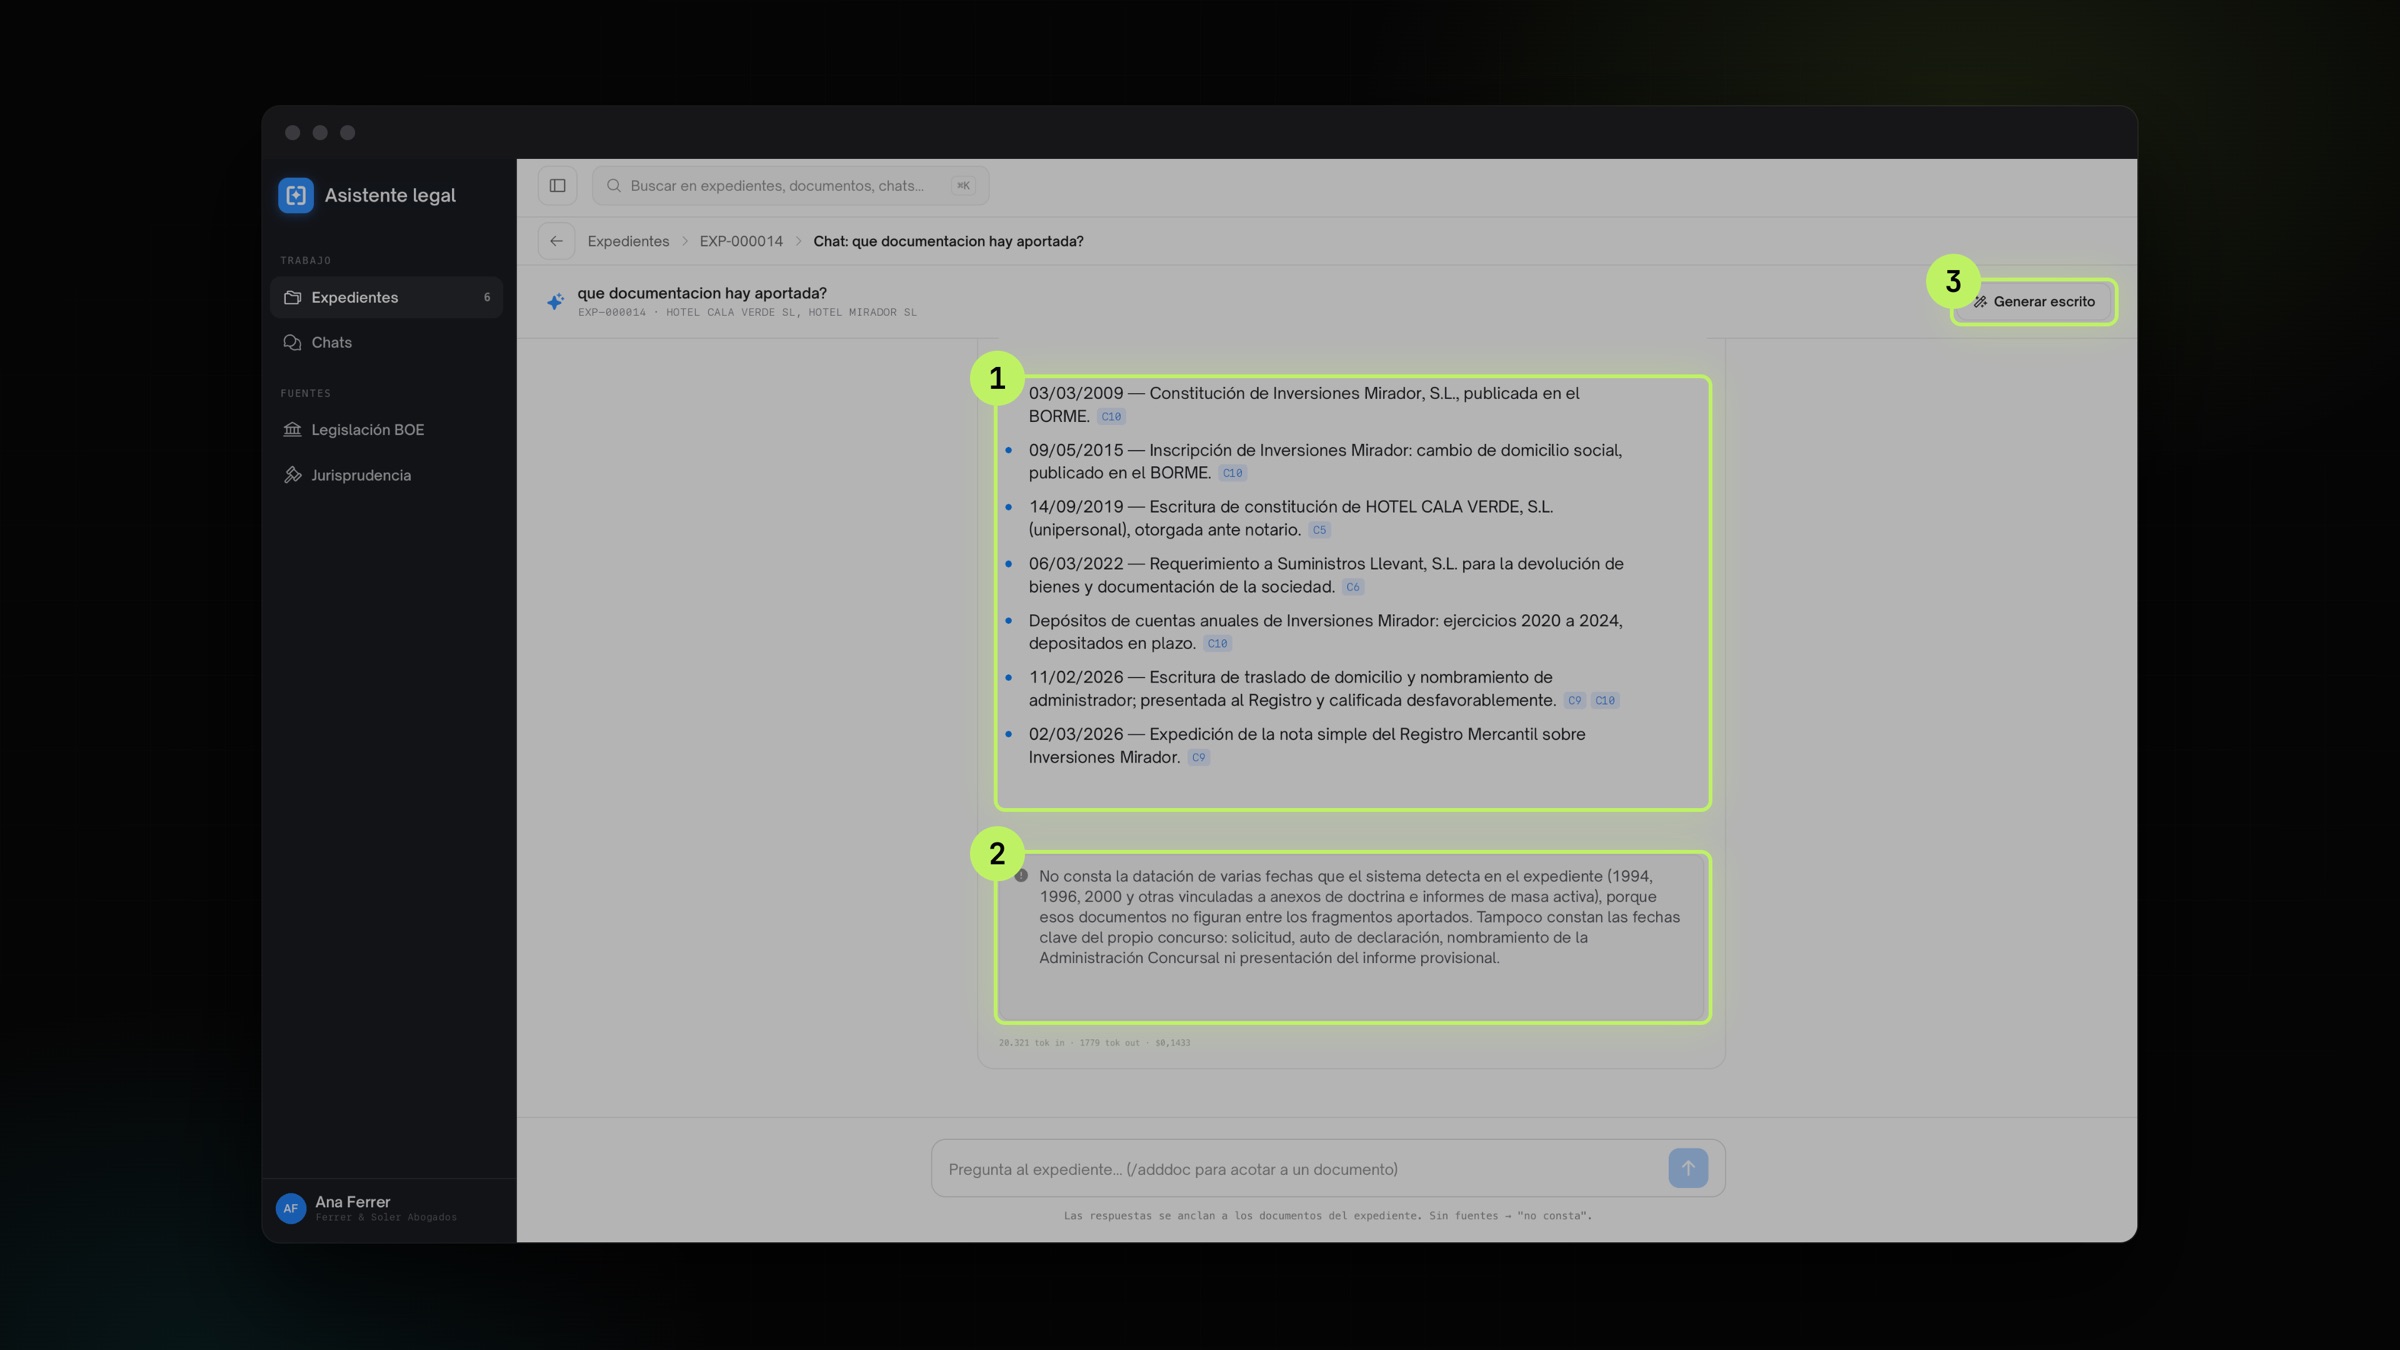 Respuesta del asistente: cada hecho lleva su cita (1), lo que no tiene base se declara como «no consta» (2) y la respuesta puede convertirse en escrito (3). Nombres ficticios.
Ingesta documental
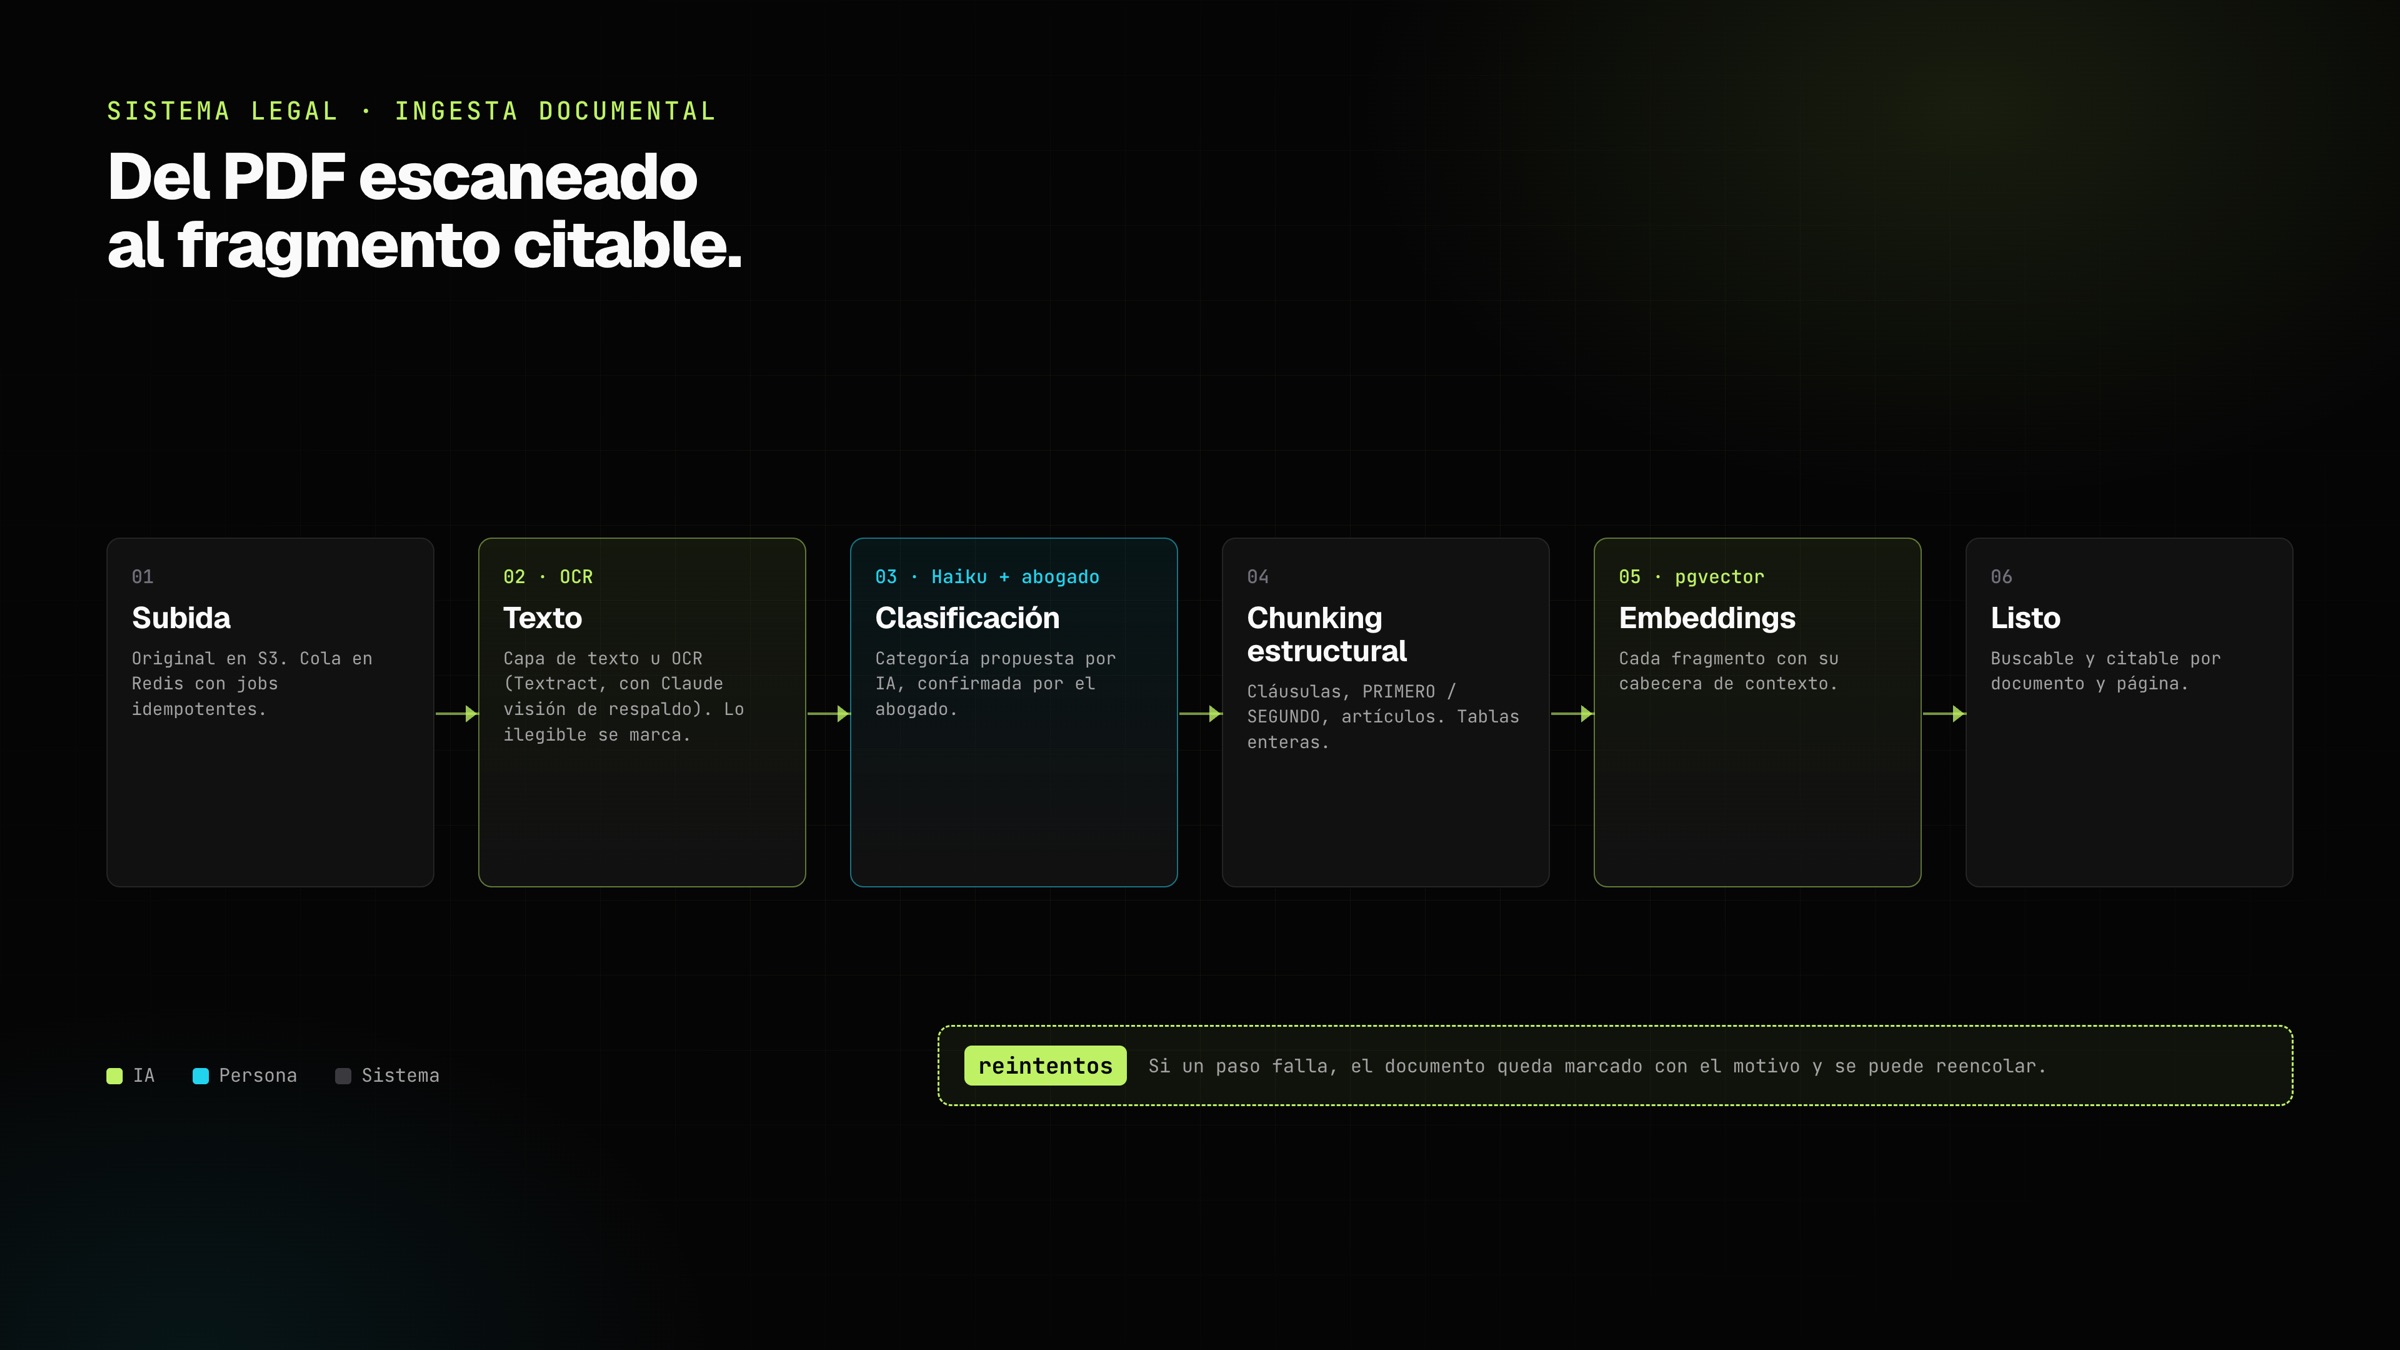
Cada documento pasa por un pipeline asíncrono de jobs idempotentes y reintentables: subida del original a almacenamiento compatible con S3, extracción de texto (capa de texto si la hay; si no, OCR con Amazon Textract y Claude visión como respaldo, con lo ilegible marcado en vez de completado), clasificación propuesta por IA y confirmable por el abogado, troceado estructural y embeddings en PostgreSQL con pgvector.
El troceado respeta la estructura legal: cláusulas, ordinales PRIMERO/SEGUNDO, artículos y apartados; las tablas se mantienen enteras y cada fragmento lleva una cabecera de contexto («Contrato · Cláusula 5: Duración») que mejora a la vez la búsqueda y la cita.
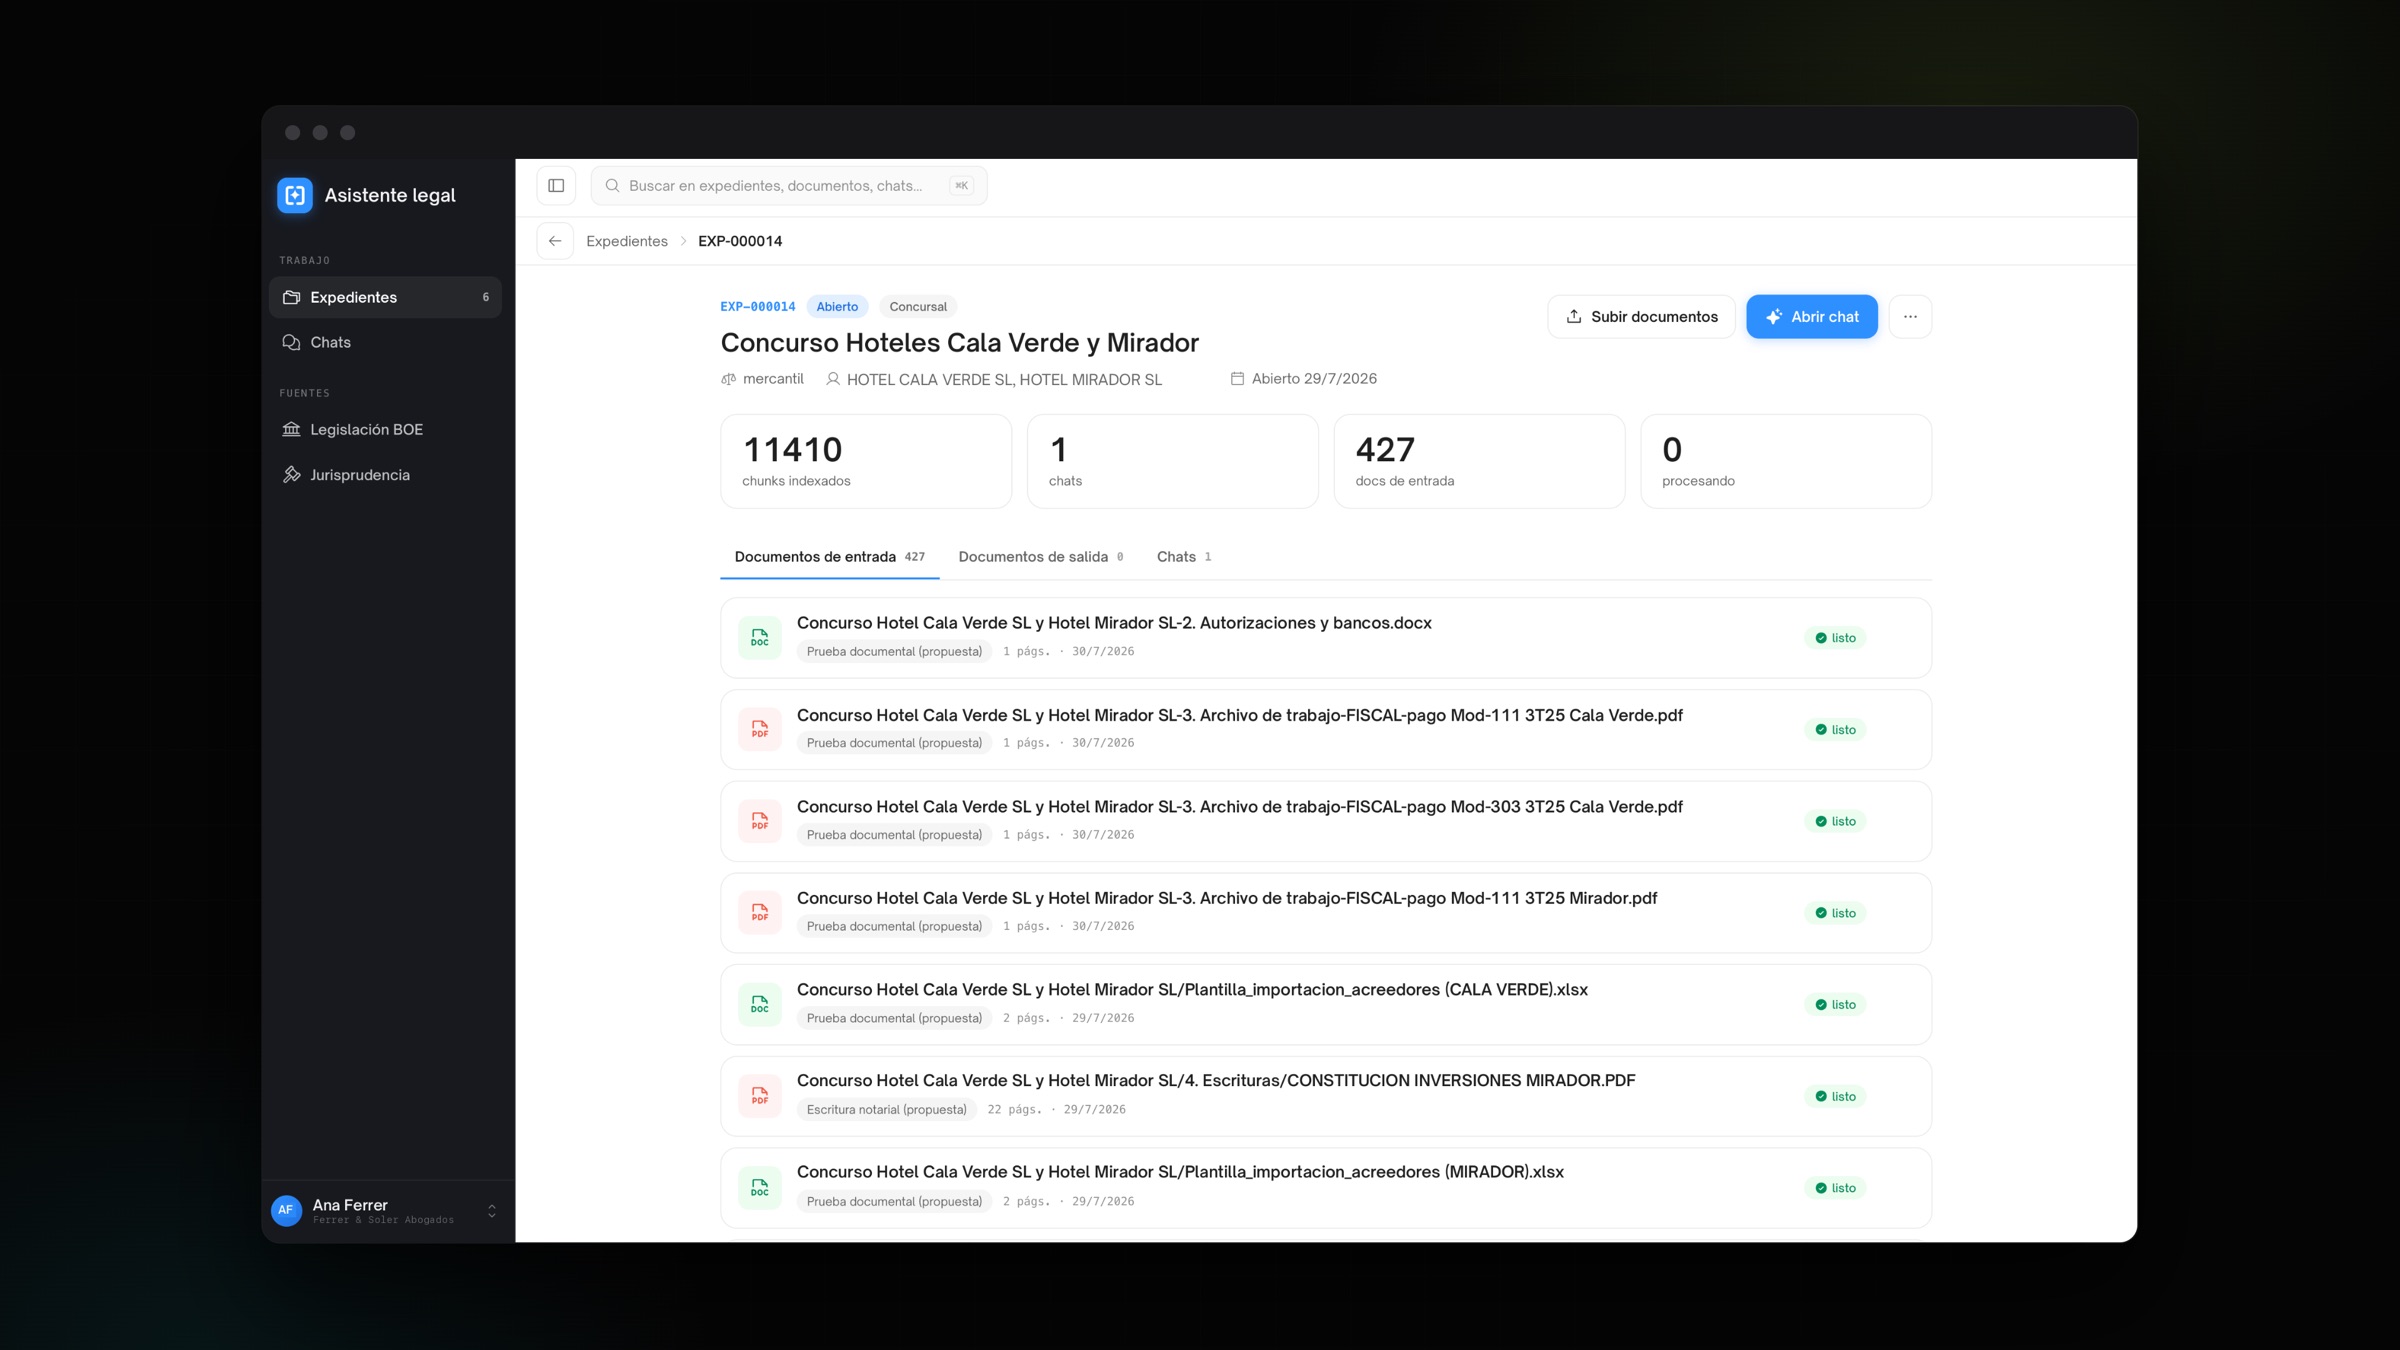 Expediente: fragmentos indexados, documentos de entrada con su categoría propuesta y estado. Datos ficticios.
Búsqueda híbrida y reranking
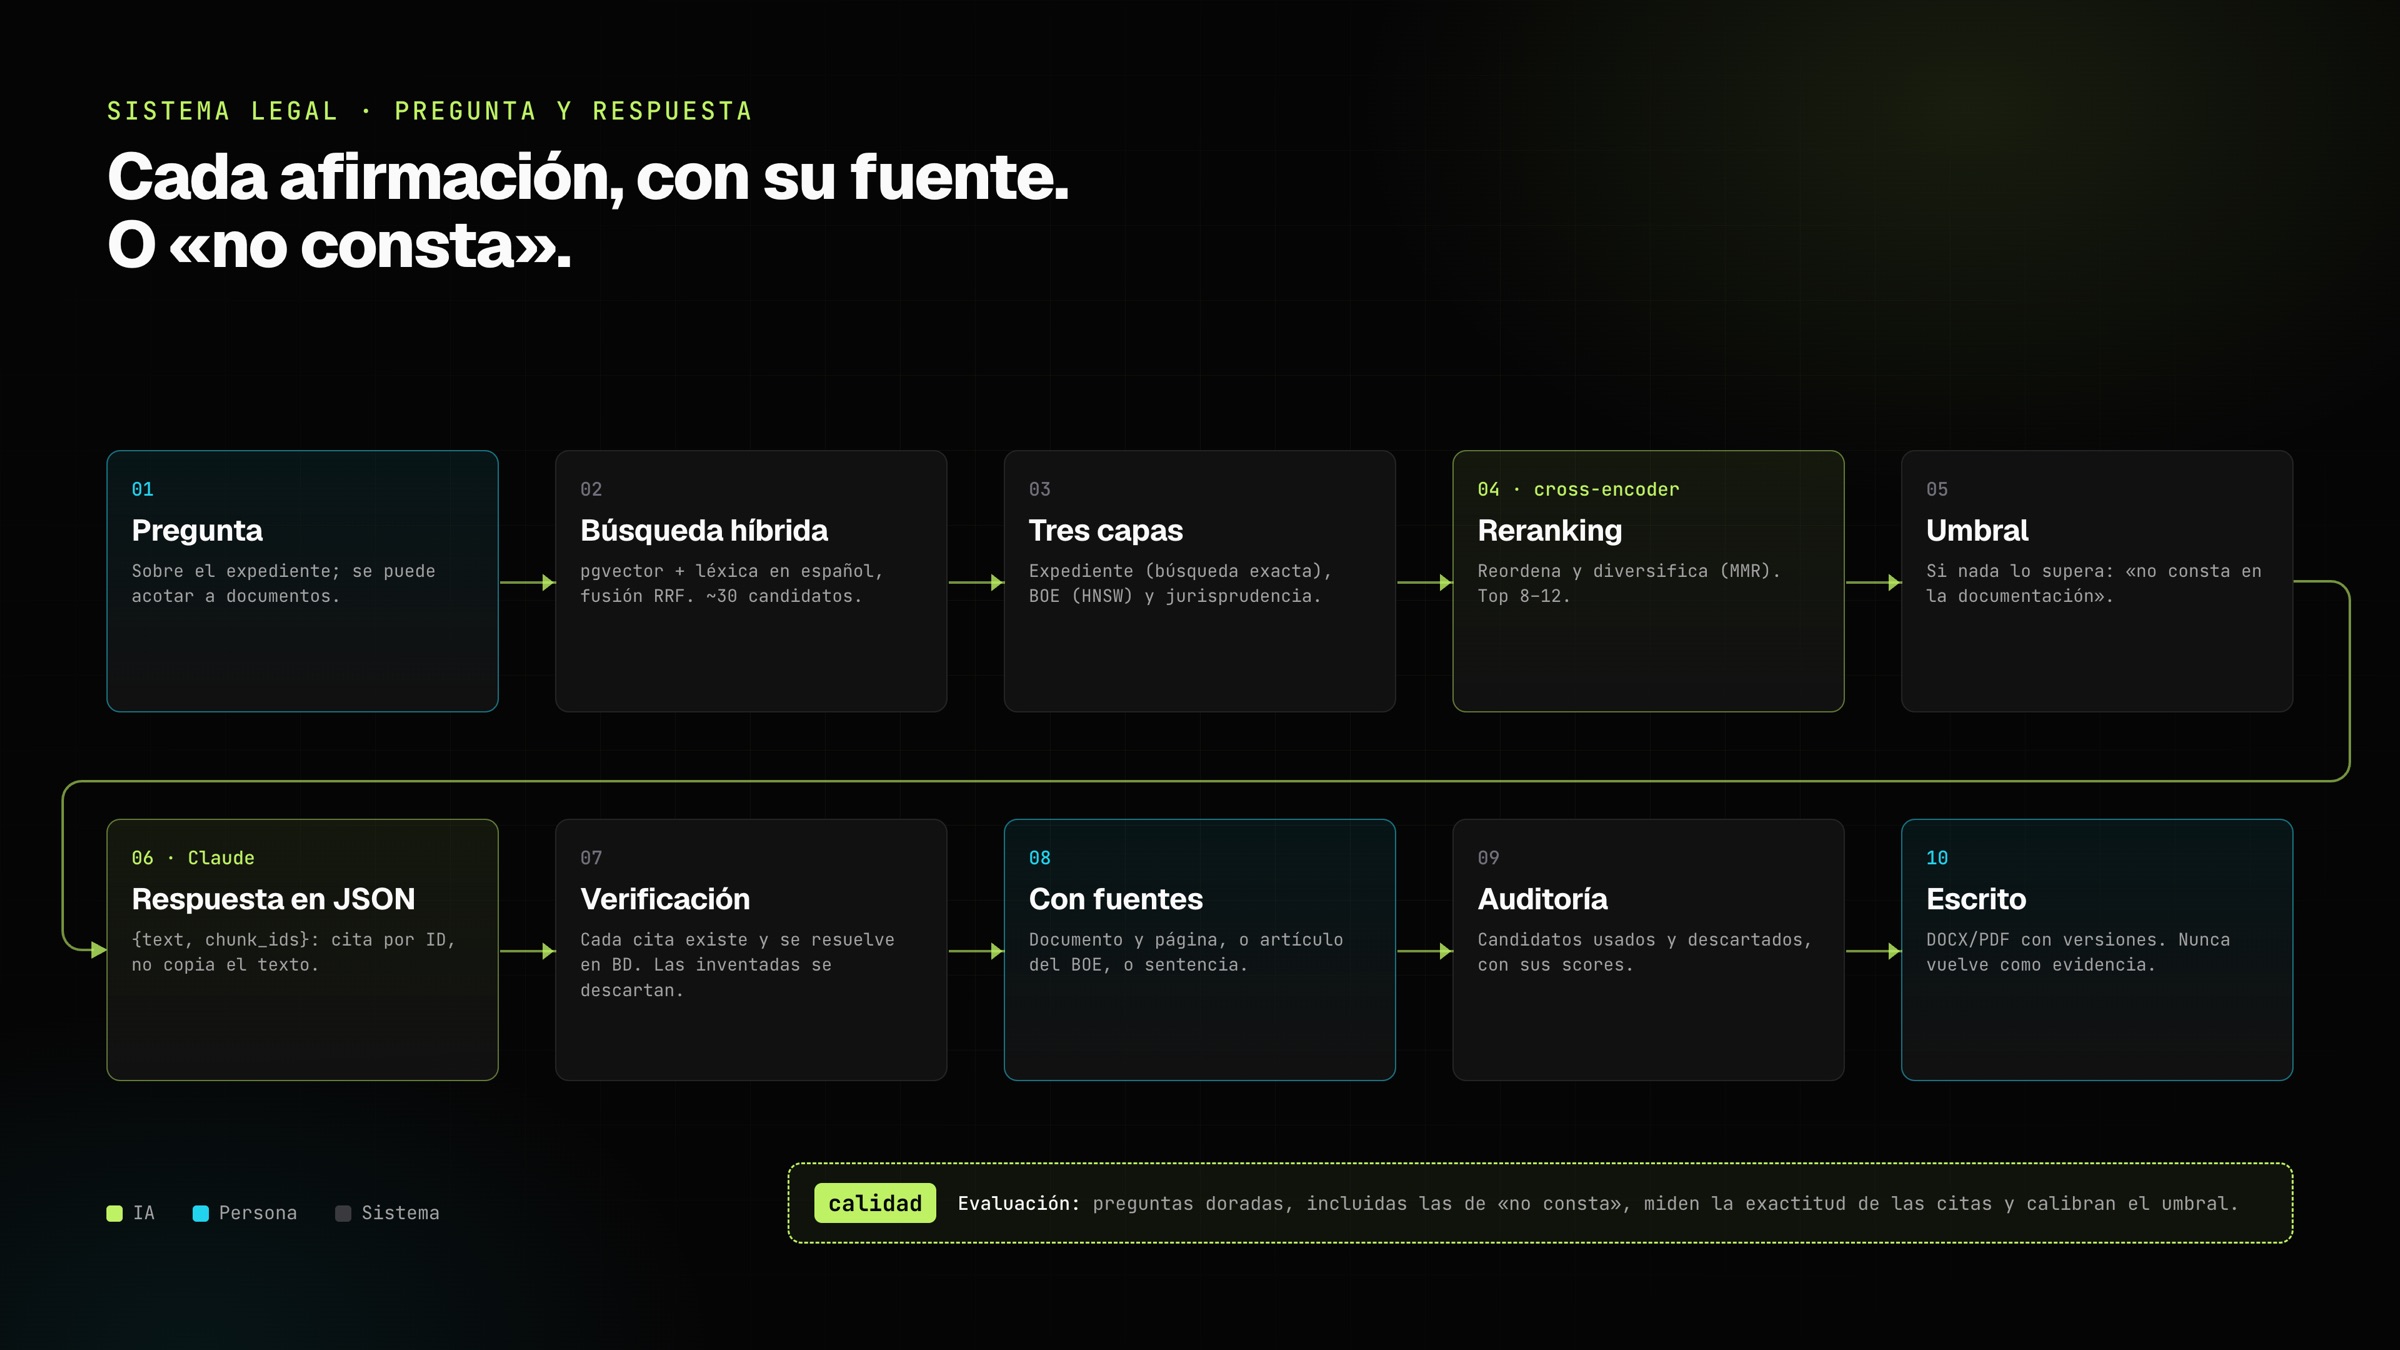
La recuperación combina búsqueda vectorial y léxica en español (para números de artículo, de procedimiento o importes que exigen coincidencia exacta), fusionadas con Reciprocal Rank Fusion. En el expediente la búsqueda es exacta, sin aproximaciones, para no perder nada; en el BOE, que es grande y compartido, se usa un índice HNSW. Después, un cross-encoder reordena los candidatos y MMR evita repetir fragmentos casi iguales.
Citas verificables o «no consta»
Claude responde en JSON estructurado y cita por identificador de fragmento: nunca reproduce el texto de la fuente. El sistema comprueba que cada cita existe en el contexto enviado y la resuelve contra la base de datos a su documento y página, artículo o sentencia; las citas inventadas se descartan. Si ningún fragmento supera el umbral de relevancia, la respuesta es «no consta en la documentación»: sin fuentes no hay análisis. Cada respuesta guarda su auditoría (candidatos usados y descartados, con sus puntuaciones).
Legislación y jurisprudencia
- Legislación: BOE consolidado, cacheado bajo demanda, con fecha de versión y de última comprobación; el artículo es la unidad de búsqueda y de cita.
- Jurisprudencia: sentencias con filtros por año, órgano y materia, búsqueda y detalle con PDF, texto y fragmentos; se citan igual que cualquier otra fuente. Las da de alta un administrador de la plataforma o un proveedor licenciado.
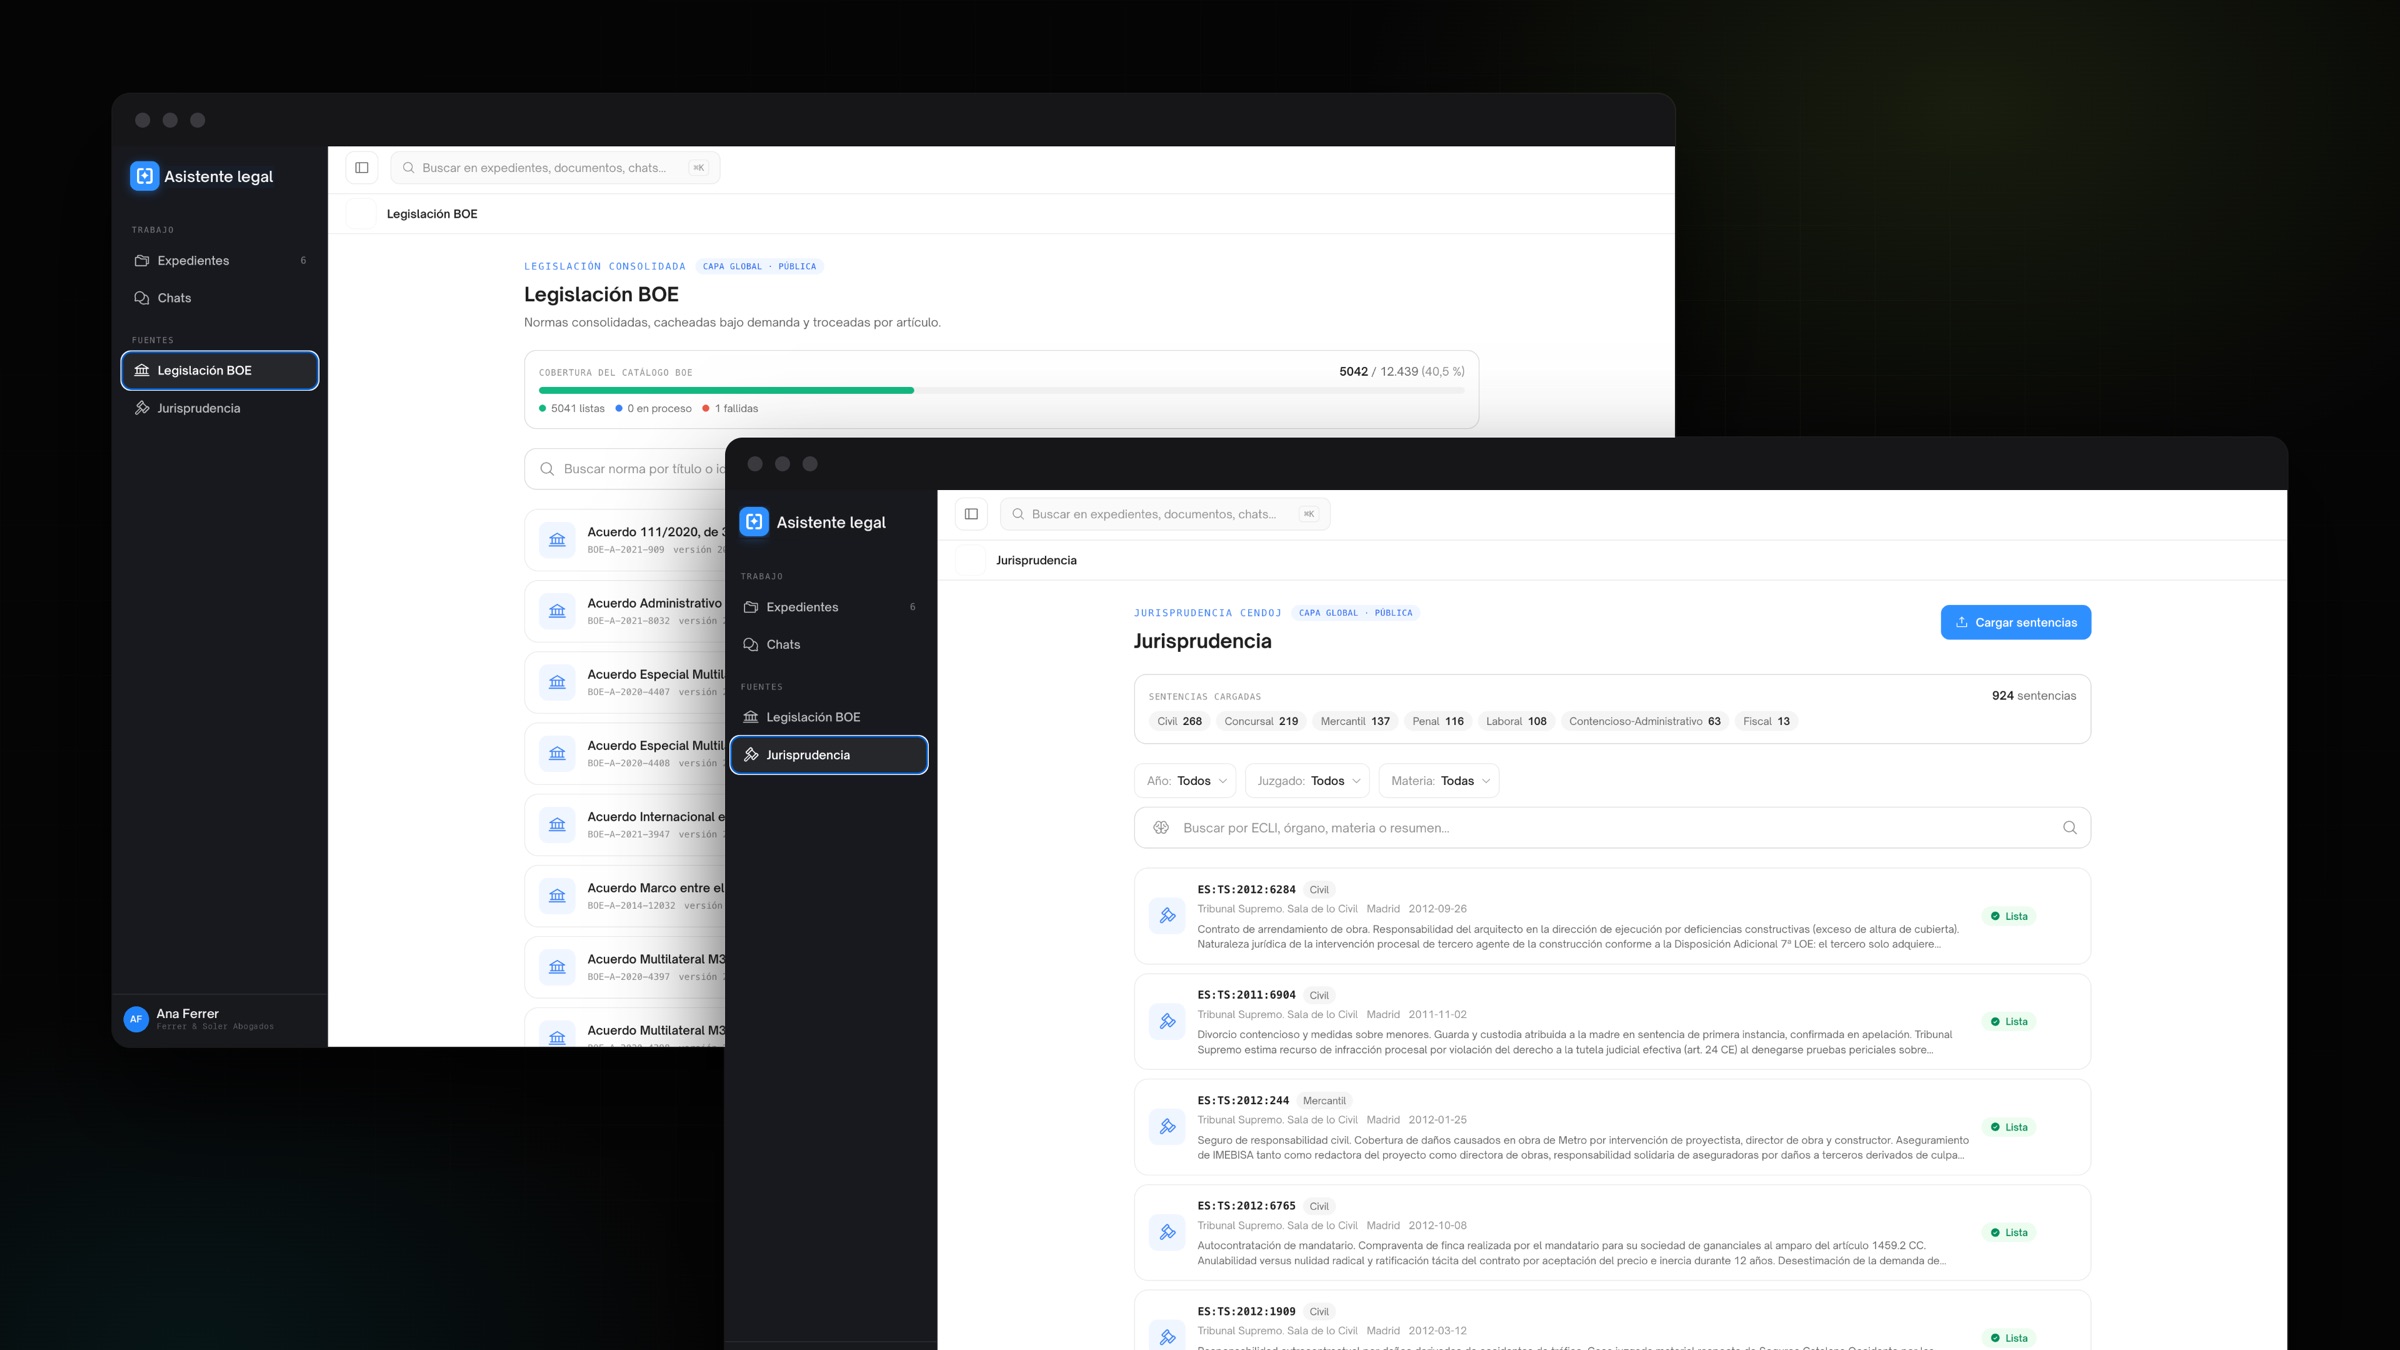 Fuentes globales: legislación consolidada y jurisprudencia.
Escritos
Una respuesta se puede convertir en escrito: un documento de salida con versiones, que se itera con instrucciones y se exporta a DOCX o PDF. Los documentos generados nunca se reindexan como evidencia del expediente.
Aislamiento entre despachos
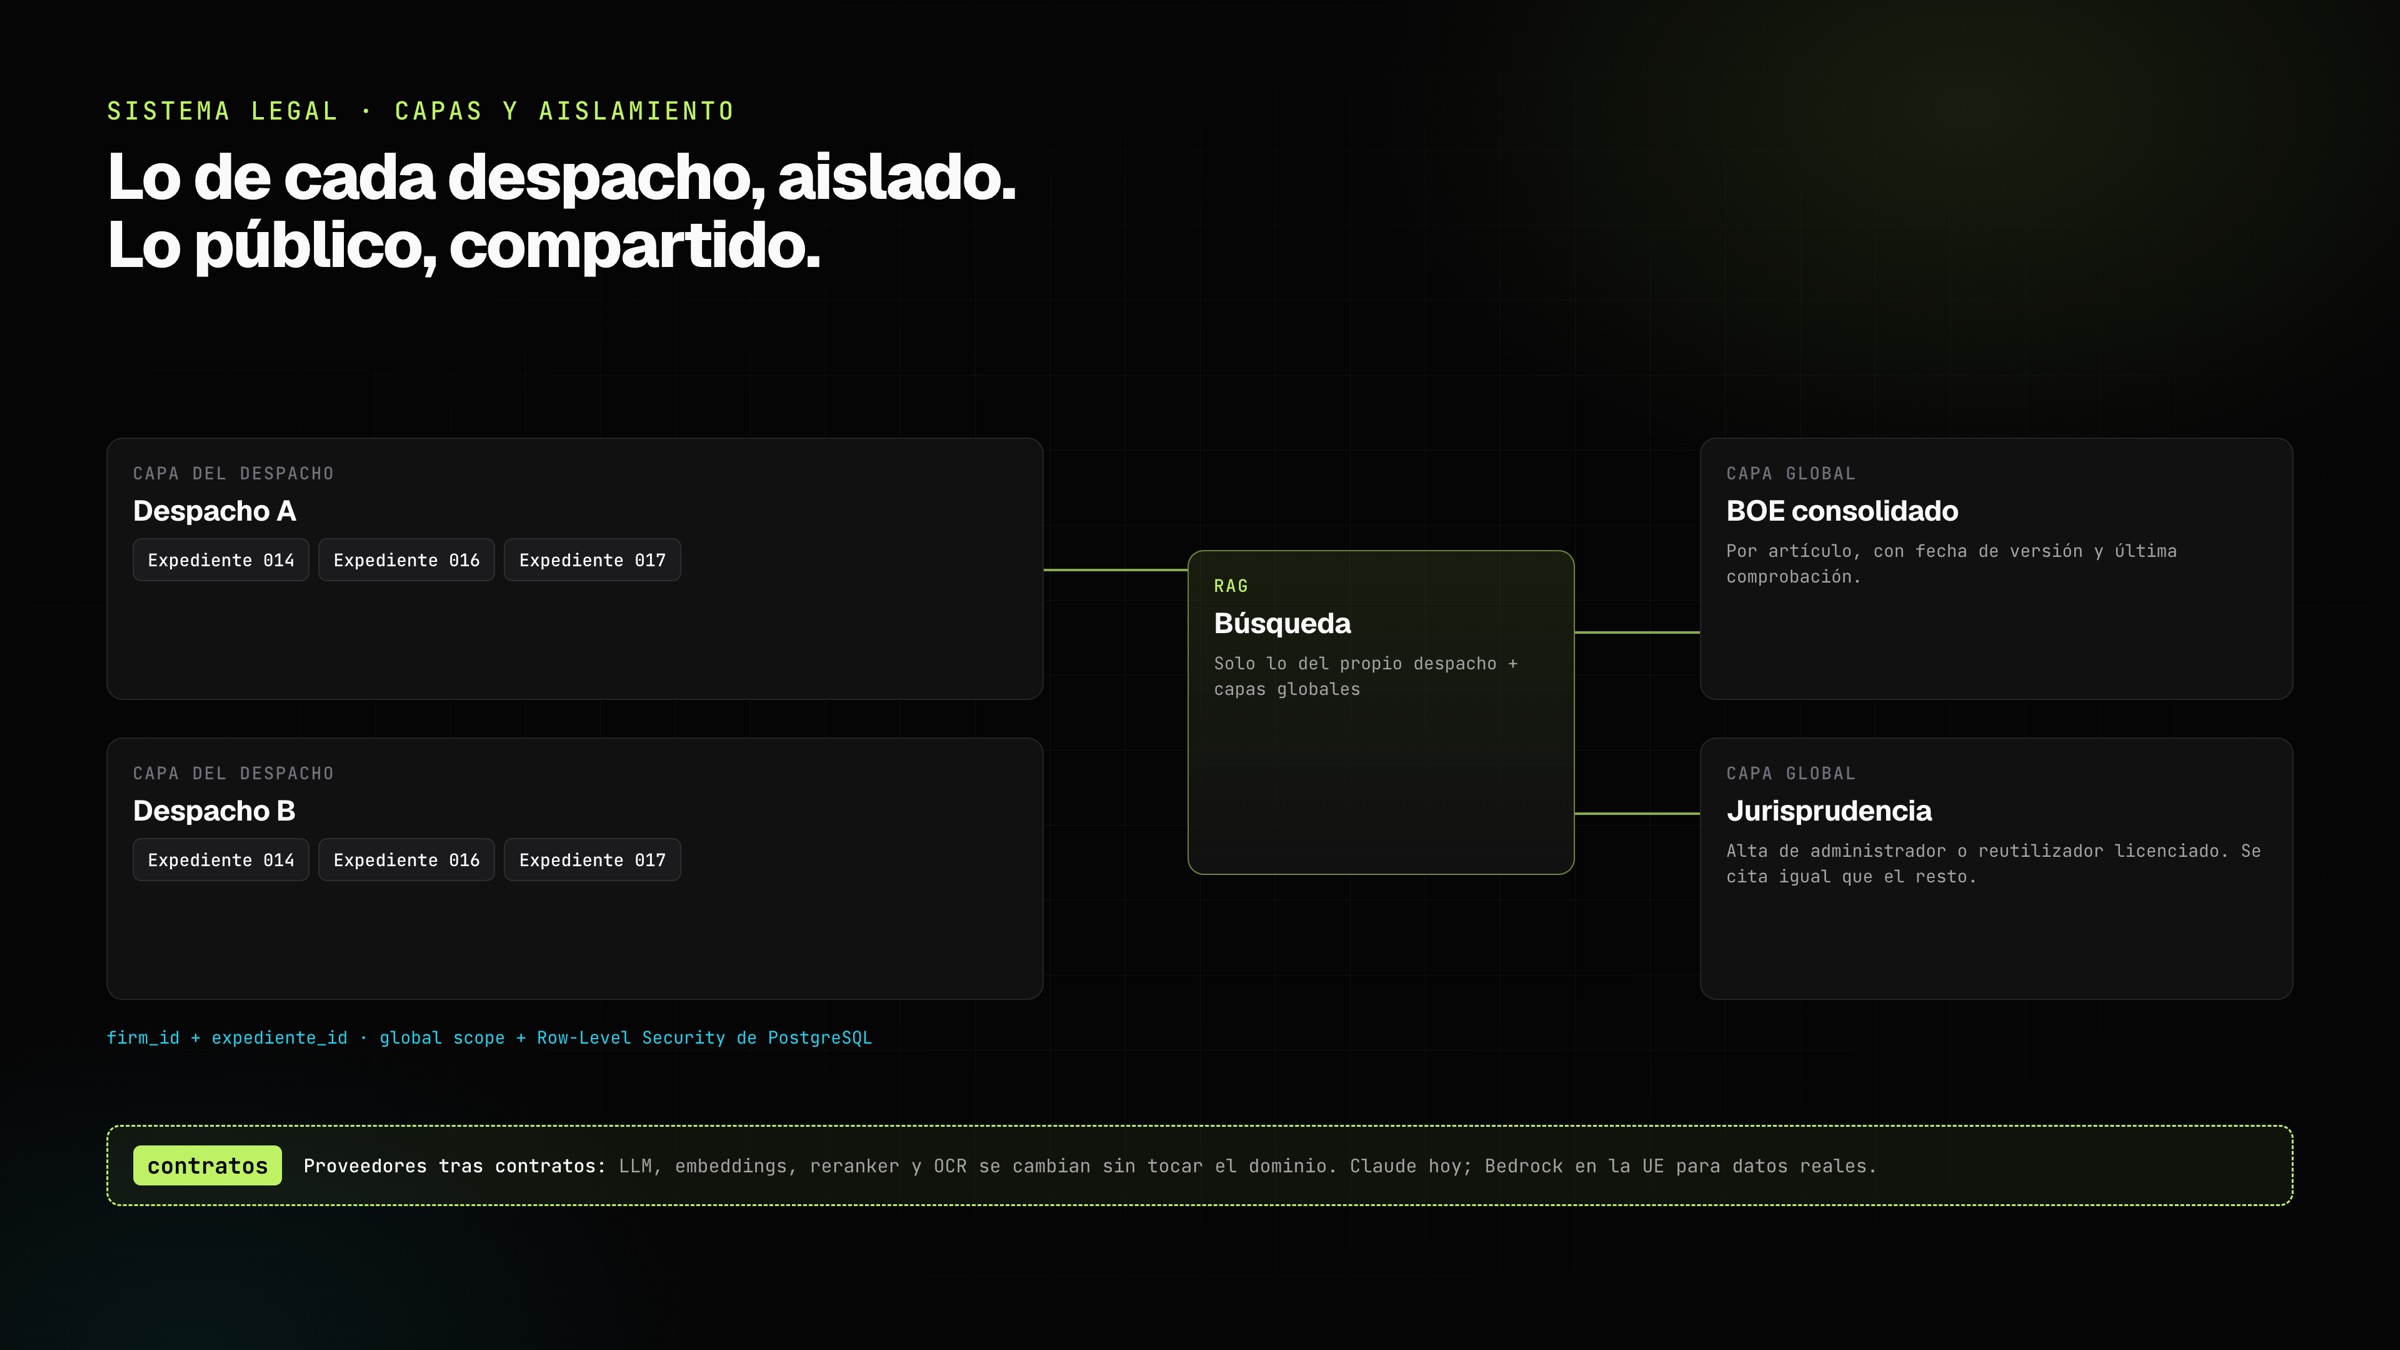
Cada consulta se filtra por despacho con un global scope de Eloquent y, como red de seguridad en la base de datos, con Row-Level Security de PostgreSQL; dentro del despacho, además, por expediente. Legislación y jurisprudencia son capas globales compartidas. Los tests de aislamiento son obligatorios, también para los jobs en cola.
Proveedores intercambiables y RGPD
El modelo de lenguaje, los embeddings, el reranker y el OCR están detrás de contratos: cambiar de proveedor es una implementación nueva, no un cambio en el dominio. Con la API directa solo se trabaja con datos ficticios o anonimizados; para datos reales de cliente el camino previsto es Bedrock en la UE con DPA y evaluación de impacto.
App móvil
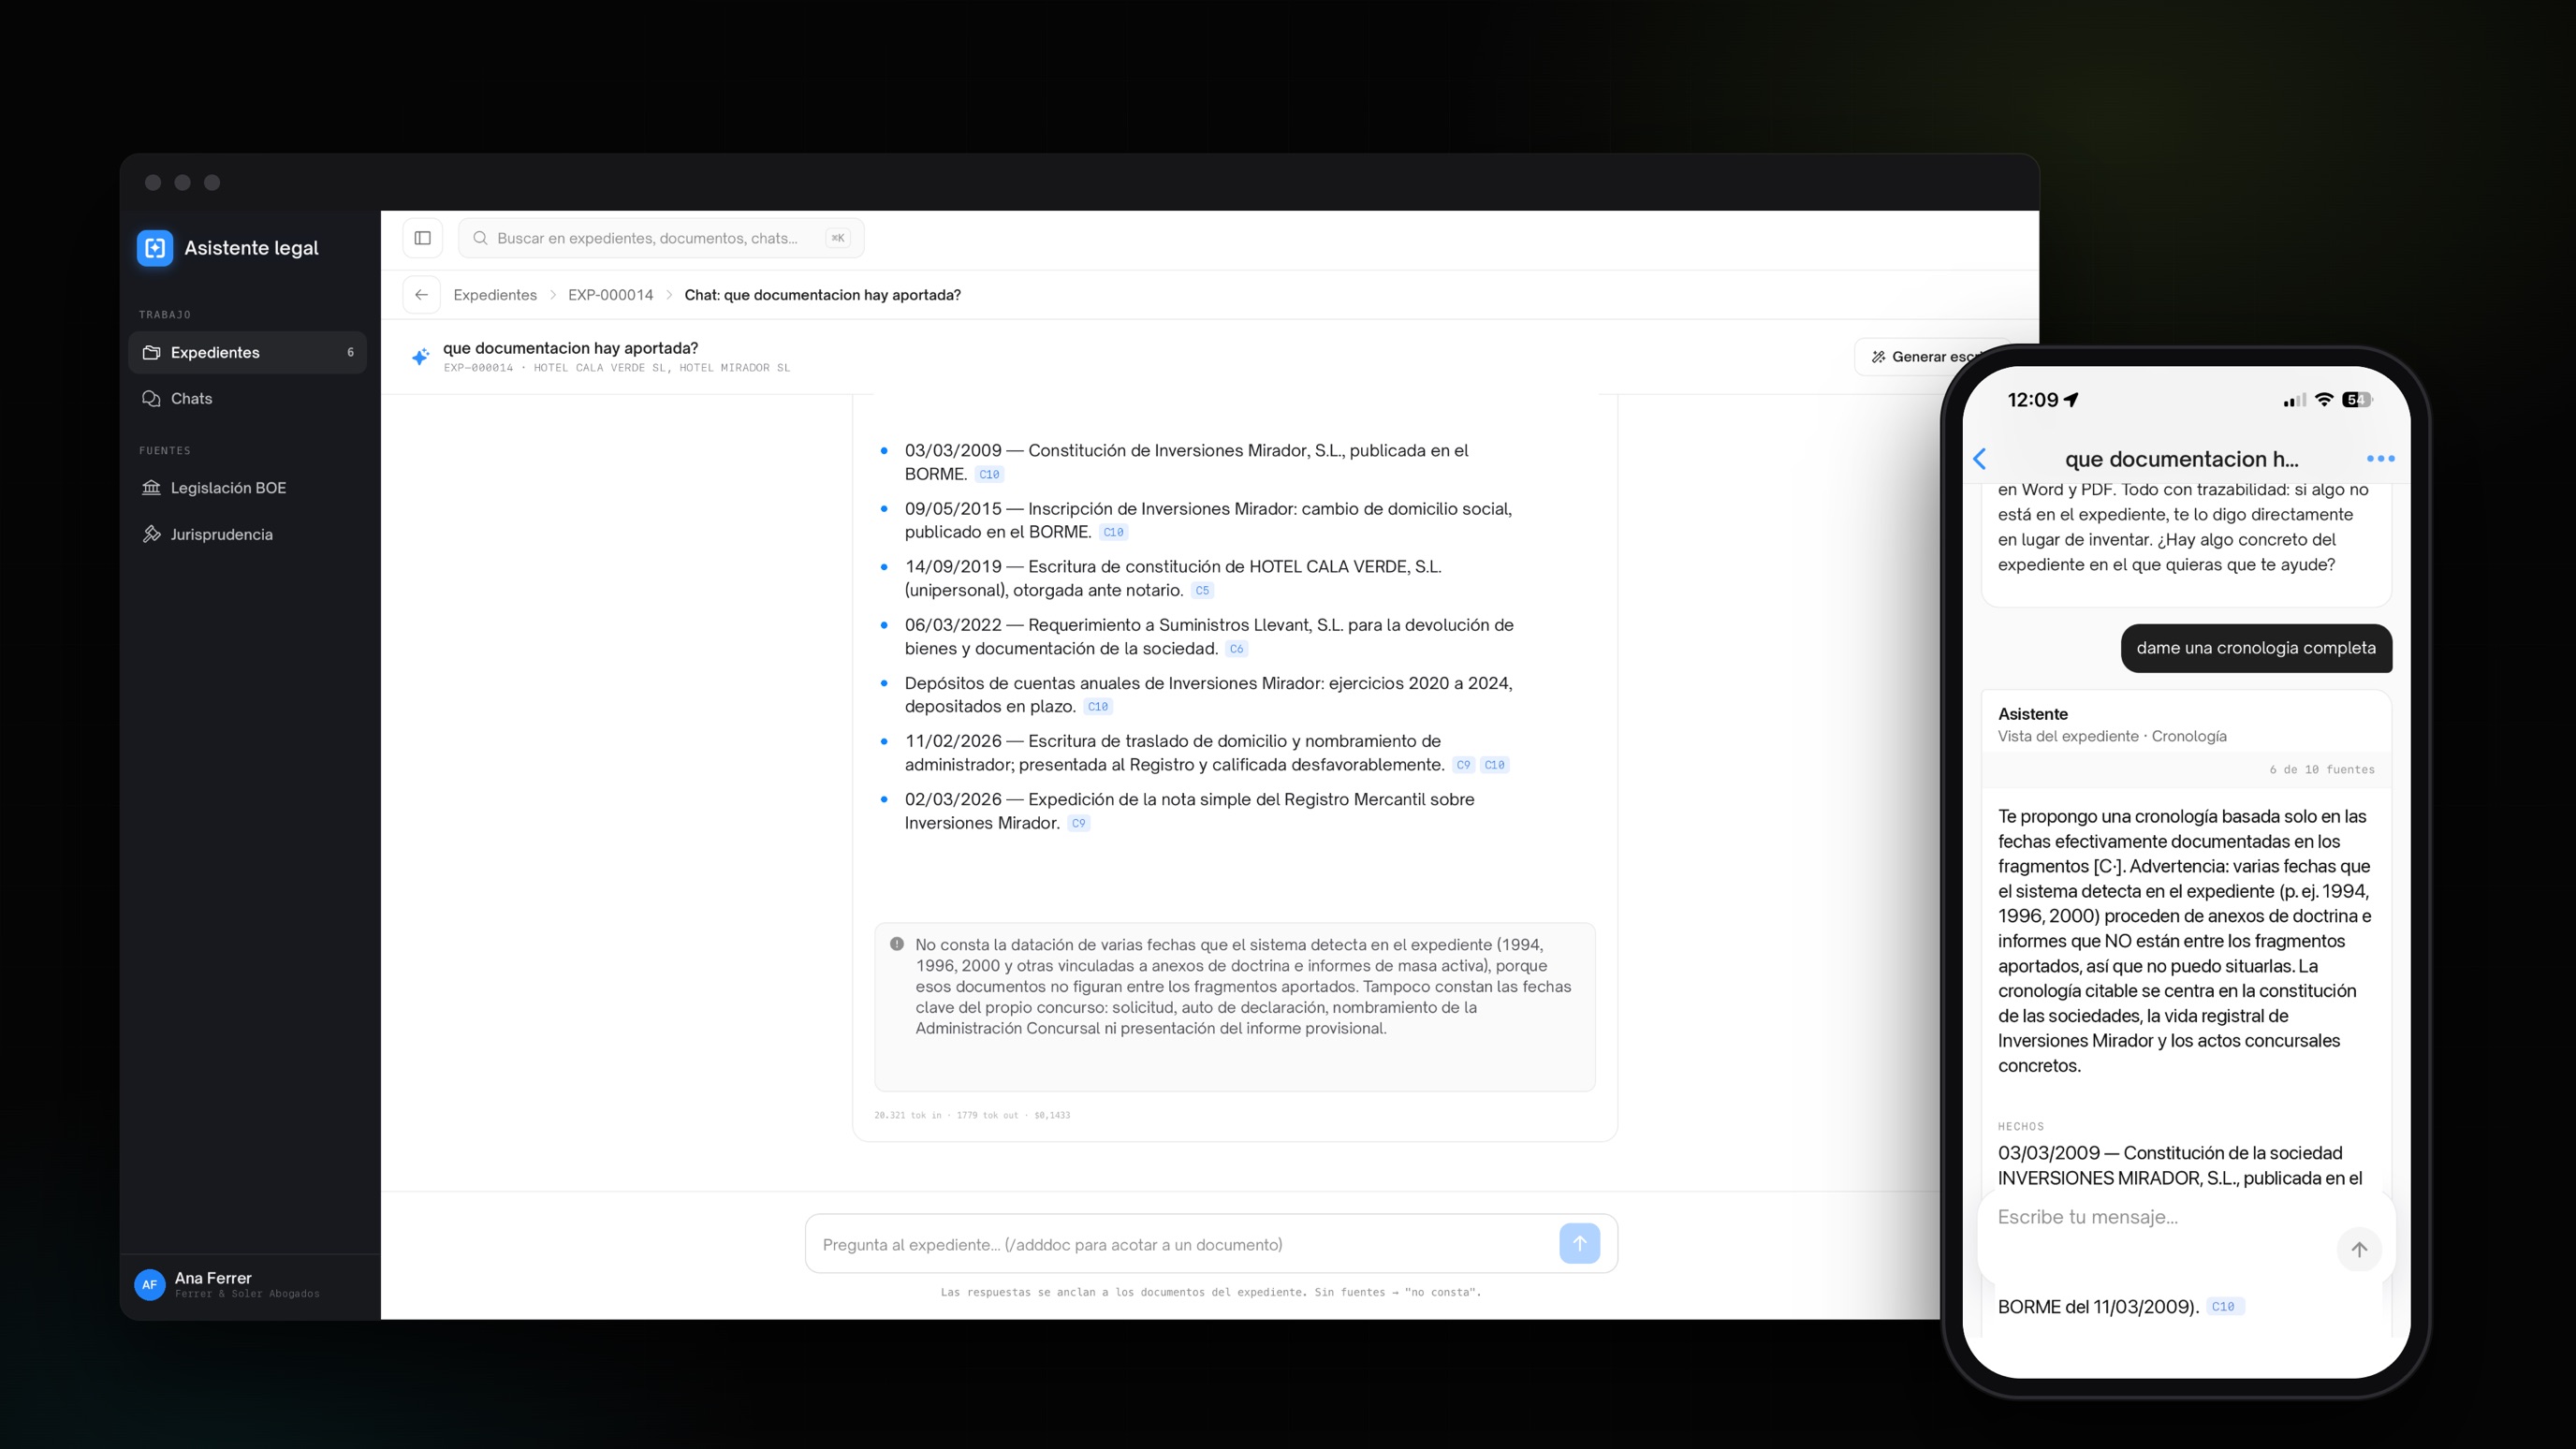
App iOS y Android con expedientes, documentos (visor de PDF e imagen, texto extraído y fragmentos), chat con citas que abren el documento, escritos y fuentes (legislación y jurisprudencia). Con 2FA y desbloqueo biométrico.
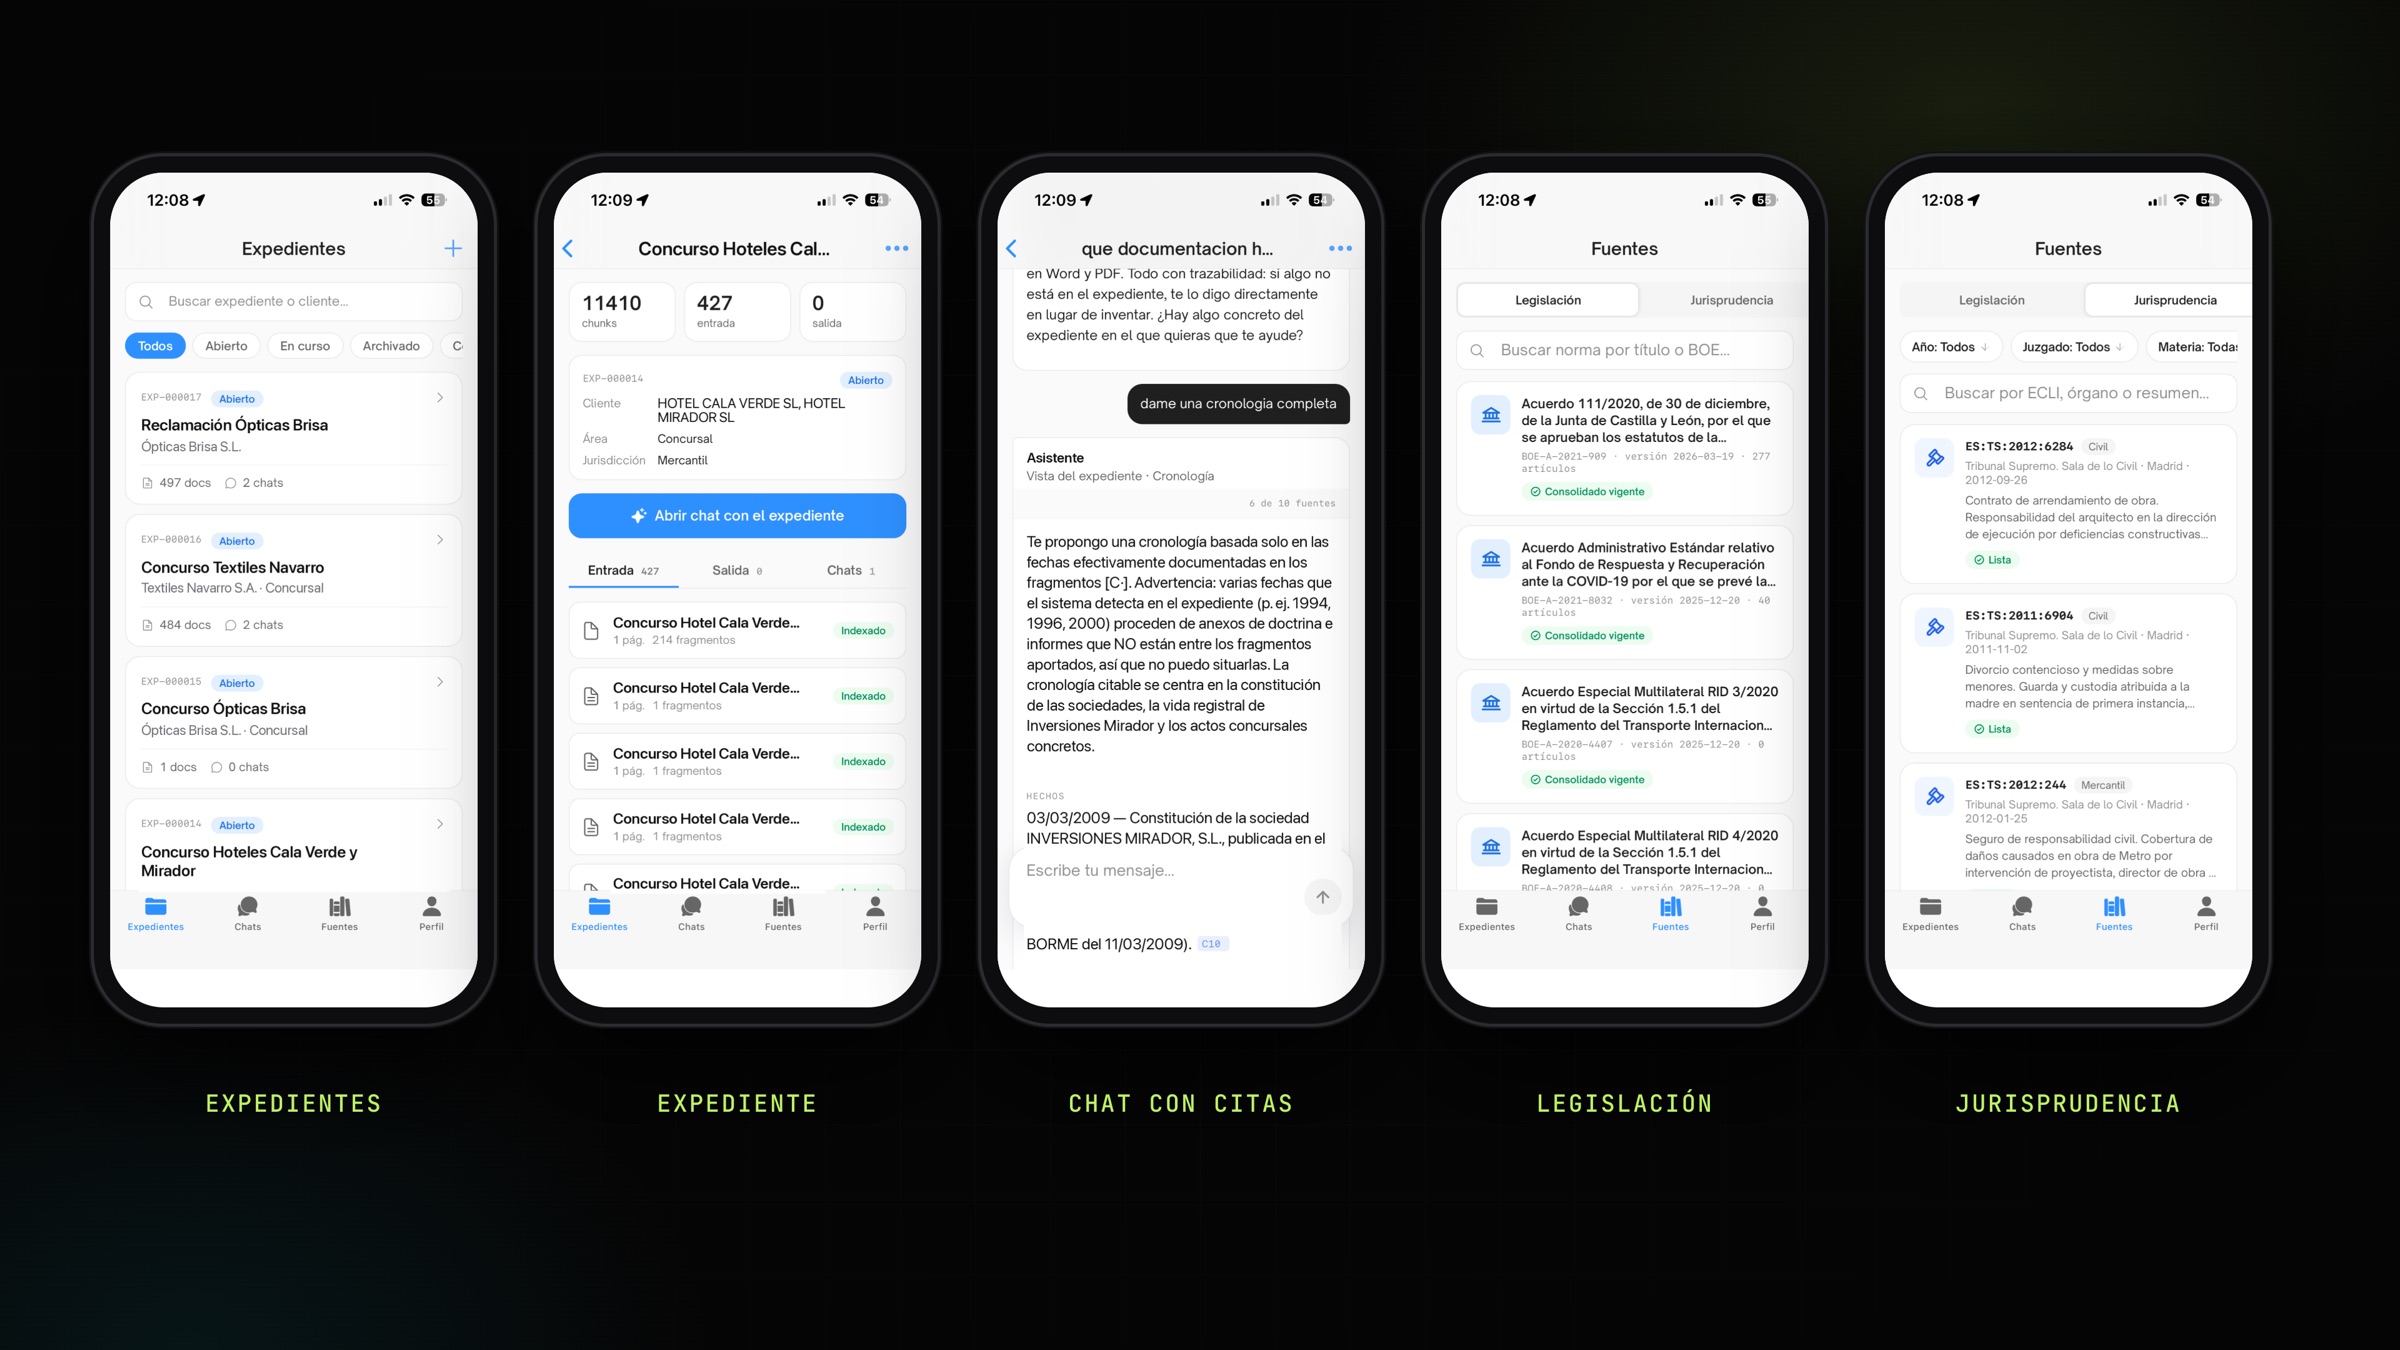 App móvil. Nombres ficticios.
Evaluación desde el día uno
Un conjunto de preguntas de referencia (golden set) sobre un expediente ficticio, incluidas preguntas cuya respuesta correcta es «no consta», mide la exactitud de las citas y la recuperación, calibra el umbral del reranker y actúa como red de regresión cada vez que se toca el troceado, la búsqueda o los prompts.
Resultado
- Respuestas con fuente verificable a documento y página, artículo o sentencia, o un «no consta» explícito.
- Expediente, BOE y jurisprudencia en una sola herramienta, en web y en móvil.
- Documentos escaneados y estructura legal tratados sin perder la trazabilidad.
- Datos de cada despacho aislados por diseño y en la propia base de datos.
Stack
- Backend: Laravel 13 como monolito modular por dominios, PostgreSQL 16 con pgvector, Redis para las colas, almacenamiento compatible con S3 para los originales.
- IA: Claude para respuestas, clasificación y OCR de respaldo; Amazon Textract para OCR; embeddings de OpenAI; reranking con Cohere; todo detrás de contratos.
- Web: React con Inertia.
- App: Ionic + Angular + Capacitor, con 2FA y biometría.
- Despliegue: Laravel Forge.